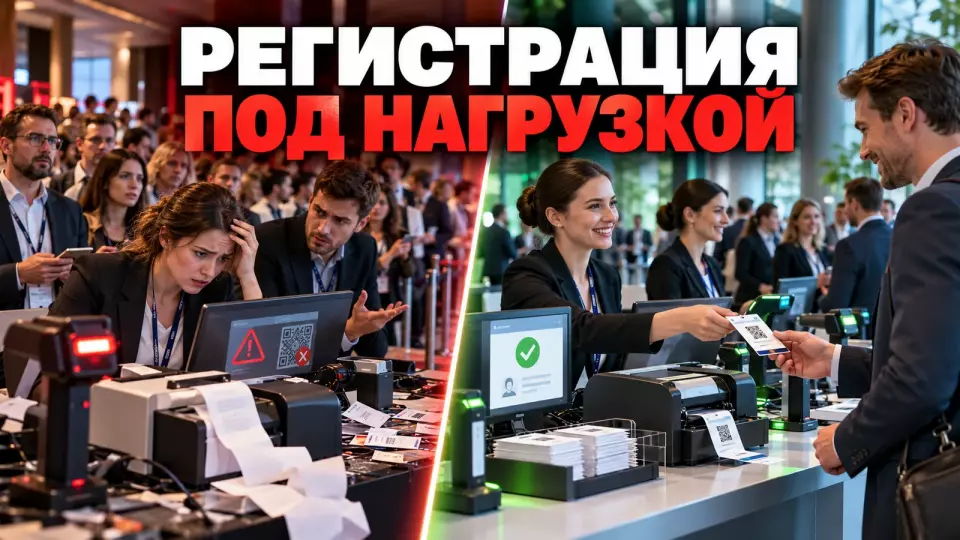
Plan práctico de aceptación del registro bajo carga: escenarios de pico, datos seguros, respaldo, criterios PASS/FAIL e informe del proveedor.
Deje su solicitud: hablemos del proyecto
Precisaremos el formato del evento y propondremos el siguiente paso.
¿Qué debe demostrar un ensayo de carga?
Un ensayo de carga del registro debe demostrar que todo el recorrido del invitado funciona con un flujo real: se encuentra el registro, se lee el código QR, el estado cambia una sola vez, se imprime la acreditación y el resultado es visible en los puestos de trabajo contiguos. Aquí el check-in consiste en buscar el registro y confirmar la llegada del invitado. Una respuesta correcta de un formulario aislado o una señal sonora del escáner todavía no demuestran que todo el proceso esté listo.
En Aventura primero definimos los límites de la prueba. El invitado presenta la invitación o pide que se busque su registro. El sistema comprueba el estado, confirma la llegada y envía los datos a impresión.
El operador recibe una confirmación clara. El mapa de dependencias también incluye servicios externos.
El recorrido general del registro se analiza en detalle en el artículo sobre el registro de participantes del evento. Aquí la tarea es más concreta: probar este recorrido bajo carga y obtener una decisión de «superado» o «no superado» según criterios definidos de antemano.
El escáner puede emitir un sonido tras decodificar correctamente el código de barras. Esto confirma la lectura del símbolo por el dispositivo, pero no el registro de un nuevo estado en el sistema central. Por eso el observador contrasta la pantalla del operador, la ficha del invitado, la impresión y la exportación final, y no solo la reacción del escáner.
El pico de flujo en términos del cliente
Definimos el pico mediante un escenario de llegada de invitados, no mediante un número redondo de usuarios virtuales. El cliente describe las franjas de llegada, la proporción del grupo principal, varias entradas, los casos manuales y las operaciones simultáneas. El equipo técnico calcula cuántas operaciones comienzan cada minuto y cuánto dura cada etapa.
Para organizar una conferencia resulta útil reunir el horario del transporte, el inicio de la sesión plenaria, el acceso a las salas y las normas de entrega de materiales. El autobús o el final del bloque general generan un escalón de demanda. Los invitados siguen llegando incluso cuando las operaciones anteriores ya se han ralentizado.
El modelo mínimo contiene:
- número de invitados previstos por franjas horarias;
- proporción de QR, búsqueda manual e invitados sin registro previo;
- número de entradas, mostradores, escáneres e impresoras;
- proporción de escaneos repetidos y reimpresiones;
- cambios tardíos de estado o categoría;
- dependencias de la red, el correo, los SMS y las bases de datos externas.
Este perfil permite comparar la carga técnica con la cola visible. El servidor puede responder rápido y, aun así, el puesto de trabajo atiende al invitado lentamente por la búsqueda, la impresión o un error poco claro. Por eso se miden por separado la operación del sistema y el ciclo completo en el mostrador.
¿Qué operaciones incluir en el guion?
El guion debe reproducir las operaciones de negocio que realiza el equipo en la entrada, incluidas las excepciones. Probar una sola página de registro genera una falsa sensación de estar preparados. El flujo principal se ejecuta junto con la búsqueda manual, el QR repetido, el registro tardío y la impresión, para ver la competencia por recursos compartidos y el impacto de los casos complejos en la cola.
Configuramos el recorrido así:
- El invitado presenta el código QR o indica los datos para la búsqueda.
- El operador localiza un único registro correcto.
- El sistema verifica el estado actual y los derechos de acceso.
- El check-in cambia el estado exactamente una vez.
- La impresora emite una acreditación con la categoría actualizada.
- El mostrador contiguo ve el cambio sin actualizar los datos manualmente.
- La exportación final contiene una única marca confirmada.
En el guion se añaden una errata, un homónimo, un caso sin código QR, un código ya utilizado, un registro tardío y una solicitud de acreditación duplicada. El conjunto detallado de soportes puede contrastarse con el artículo sobre códigos QR seguros en el evento, sin convertir la prueba de carga en una auditoría independiente de seguridad de los QR.
Un cambio tardío también debe recorrer todo el circuito. El registro se crea o se modifica después de la exportación de control y, a continuación, se comprueban la búsqueda, los permisos, la impresión y la difusión del nuevo estado. El material adjunto sobre registros tardíos ayuda a preparar ese guion sin repetir todo el calendario del proyecto.
El registro forma parte de la producción integral del evento. Si se necesita el circuito general de la sede, los proveedores y el equipo de entrada, consulte la organización de eventos corporativos: acordamos de antemano los roles, los puntos de control y las soluciones de respaldo.
También publicamos análisis prácticos sobre la preparación de la sede y el trabajo del equipo en el canal de Telegram de Aventura.
Tres modos de ejecución
En nuestro protocolo de aceptación utilizamos tres modos: una verificación breve de la cadena básica, el flujo de trabajo esperado y un pico brusco. Responden a preguntas distintas. Una aceleración gradual y uniforme puede ocultar un error del escenario, y la búsqueda de la potencia límite no confirma que el pico acordado cumpla los criterios de negocio.
En la tabla se recogen los puntos clave de la sección: Modo, Qué lanzamos, Qué queremos saber. Utilícela como referencia rápida al preparar el evento.
| Modo | Qué lanzamos | Qué queremos saber | Decisión del cliente |
|---|---|---|---|
| Ejecución básica | varios registros de cada tipo | si funciona la cadena y si los datos de prueba son correctos | si se puede pasar a una carga grande |
| Flujo esperado | perfil de llegada proyectado en el tiempo | si el sistema soporta el escenario de trabajo acordado | si se ha superado el criterio principal de aceptación |
| Pico brusco | crecimiento rápido del inicio de operaciones | cómo se manifiesta la degradación y si el equipo la detecta | si hay reserva suficiente y si las condiciones de parada están claras |
En la documentación de k6 hay modos específicos para la verificación básica, la carga normal, la sobrecarga, el pico brusco y la búsqueda del límite del sistema. El cliente no tiene por qué dominar la configuración de la herramienta, pero sí debe entender el objetivo de la ejecución.
Un modo muestra la reacción ante una afluencia repentina, otro busca el límite. La ejecución de trabajo confirma un escenario concreto del evento.
Antes del gran ensayo, el equipo hace una ejecución básica de cada ruta. Detecta registros de prueba incorrectos, falta de permisos necesarios y errores de integración. Después, la carga aumenta según el perfil acordado, no según la improvisación del especialista técnico.
¿Cómo preparar datos de prueba seguros?
Para el ensayo es mejor utilizar perfiles sintéticos que reproduzcan la estructura de la base de invitados sin contactos reales. El conjunto incluye distintos roles y categorías. Algunos registros imitan apellidos similares, cambios tardíos y excepciones. Antes del lanzamiento, el equipo acuerda los accesos y el plazo de eliminación, y traslada los envíos externos a un entorno de prueba seguro.
Los principios del artículo quinto de la Ley Federal N.º 152-FZ exigen una finalidad concreta del tratamiento, la correspondencia de los datos con esa finalidad y la ausencia de exceso. Para una prueba de carga, esto es un argumento práctico para no copiar la base de producción «por realismo» si el mismo escenario puede reproducirse con registros ficticios.
El conjunto se prepara por pasos:
- Se determinan los campos y estados que realmente intervienen en el check-in.
- Se crean registros sintéticos de las categorías y la distribución necesarias.
- Se marcan por separado los registros para QR repetido, cambio tardío y reimpresión.
- Se limitan los accesos de operadores y observadores a roles de prueba.
- Se bloquea el envío de correos y mensajes a destinatarios reales.
- Se fija el plazo de eliminación de registros, logs y exportaciones tras la aceptación.
Los requisitos legales sobre el formulario y los consentimientos deben verificarse por separado. Para ello existe el material sobre el formulario de registro conforme a la Ley Federal N.º 152-FZ. En el ensayo de carga comprobamos el esquema de datos ya aprobado. La composición de los registros de prueba, los accesos, el registro de eventos y los plazos de conservación se acuerdan con el responsable de datos personales o con el abogado.
Criterios «superado / no superado» (PASS/FAIL) antes del lanzamiento
PASS/FAIL significa «superado / no superado» según un criterio registrado de antemano. Registre los criterios de aceptación antes de la prueba y vincúlelos con el recorrido del invitado prometido. No existe una norma universal de latencia ni de número de operaciones. El equipo del proyecto define el flujo admisible, los errores, el tiempo de servicio y las reglas de detención, y luego compara con ellos el resultado real sin ajustar los umbrales a posteriori.
En la tabla se recogen los puntos clave de la sección: Objeto, Qué registrar, Ejemplo de formulación del criterio sin un valor normativo inventado. Úsela como referencia rápida al preparar el evento.
| Objeto | Qué registrar | Ejemplo de formulación del criterio sin un valor normativo inventado |
|---|---|---|
| Flujo | operaciones iniciadas por tiempo | se ha creado un perfil acordado sin caídas inexplicables del generador |
| Check-in | tiempo, errores, tiempos de espera, respuesta «demasiadas solicitudes» | la operación se ajusta al umbral del proyecto para la proporción de solicitudes acordada |
| Estado de negocio | registro final y duplicado | una operación crea una única marca correcta |
| Impresión | cola y correspondencia de la acreditación | la acreditación corresponde al registro actual y no se imprime de nuevo sin motivo |
| Puesto de trabajo | ciclo completo de servicio | el operador completa el escenario sin saltarse el proceso aprobado |
| Reserva | conmutación y verificación inversa | los datos tras la recuperación cuadran sin pérdidas ni entradas dobles |
Las condiciones de umbral de k6 marcan automáticamente si se ha superado el criterio para la métrica. Los valores concretos de la documentación no pueden trasladarse al proyecto como valor normativo. Los determinan el propietario del sistema, el cliente y el equipo operativo teniendo en cuenta la cola admisible y el servicio prometido.
Un criterio especial afecta al generador de carga. Si las operaciones planificadas no se iniciaron, el informe describe un flujo menor que el declarado. La métrica dropped_iterations ayuda a separar la degradación del sistema sometido a prueba de la falta de recursos o de una configuración incorrecta del propio generador.
¿Qué romper durante el ensayo?
Durante el ensayo desactivamos o ralentizamos por turnos dependencias concretas dentro de una ventana acordada: la red, la impresora, un servicio externo o un puesto de trabajo. El equipo comprueba la velocidad de detección, la claridad del mensaje y el paso al respaldo. Cada fallo se activa según un guion con derecho a detención inmediata y con un responsable de la prueba designado de antemano.
Un conjunto útil de fallos:
- red lenta o temporalmente no disponible;
- fallo de un escáner o de una impresora;
- respuesta perdida tras un check-in realmente ejecutado;
- respuesta HTTP «Demasiadas solicitudes» con indicación de la pausa hasta el reintento;
- base de datos externa o servicio de impresión no disponible;
- pulsación repetida del operador debido a un estado poco claro;
- recuperación de la dependencia tras marcas manuales.
Los reintentos automáticos inmediatos pueden generar una nueva oleada de solicitudes: un servicio ya sobrecargado recibe aún más peticiones y tarda más en recuperarse. Si la operación cambia el estado del invitado, un reintento a ciegas puede crear un duplicado. El sistema debe distinguir entre reintento seguro, espera y verificación manual del resultado.
La parte de red conviene acordarla con el responsable de la infraestructura del recinto. El artículo sobre el Wi-Fi para invitados en una conferencia explica por qué el registro de servicio no debe evaluarse con una única prueba general de velocidad junto con el tráfico de invitados.
Mostradores, códigos QR y retroalimentación
La prueba de laboratorio se complementa con un ensayo presencial en mostradores, dispositivos y soportes reales. El equipo revisa pantallas de teléfonos con distinto brillo, códigos en papel, reflejos, acercamientos repetidos y ruido. El operador debe ver un resultado inequívoco de la operación que no dependa solo del sonido o del color en la interfaz.
GS1 relaciona la legibilidad de un código bidimensional con el margen libre alrededor del símbolo, el contraste, una cuadrícula uniforme y la ausencia de ruido gráfico. Por eso en el ensayo se incluyen los tamaños, materiales y formas de presentación que recibirán los invitados. Una imagen de prueba perfecta en el monitor no sustituye al soporte real.
En nuestro escenario comprobamos seis estados diferenciables: «código leído», «verificación en curso», «entrada confirmada», «ya registrado», «registro no encontrado» y «sin conexión». La guía del W3C sobre mensajes de estado exige que el cambio de estado pueda determinarse por software sin forzar el traslado del foco. Para el mostrador esto también es una cuestión de rapidez en la formación del personal.
El esquema físico de accesos, las colas y la ubicación de los equipos deben tenerse en cuenta al elegir el recinto. El sistema puede superar la prueba del servidor pero perder capacidad por un vestíbulo estrecho, una única cola para varias categorías o una impresora a la que los operadores llegan cruzando el flujo de invitados.
¿Cómo comprobar la reserva y la recuperación?
La reserva se considera operativa solo tras el cambio efectivo, la continuación del registro y la conciliación inversa. Si se declara un modo local o autónomo, el equipo desconecta la dependencia principal, acumula operaciones, restablece la conexión y comprueba los conflictos. Si no hay modo autónomo, se ensaya el proceso manual y el comando único de transición para todos los puestos.
El escenario de recuperación se desarrolla así:
- El responsable del simulacro anuncia el fallo de la dependencia seleccionada.
- El equipo registra el tiempo de detección y el síntoma visible.
- El responsable sénior de registro da un único comando de conmutación consensuado.
- Los operadores continúan el registro por la ruta de reserva.
- El observador registra las marcas manuales y locales.
- El servicio principal se restablece según el orden acordado.
- Los datos se concilian, los conflictos se resuelven y se confirma la versión final.
El esquema detallado de conexión y de trabajo con listas locales está en el artículo sobre evento sin internet móvil. En el simulacro actual importan los puntos de transición y la sincronización inversa: quién da el comando, qué ve el operador y cómo se excluye la doble marca de asistencia.
La reserva no debe activarse por iniciativa propia de cada puesto. Las decisiones locales no consensuadas crean varias versiones de la verdad. Un solo responsable toma la decisión sobre el modo, y el registro del simulacro conserva la hora, el motivo y el alcance.
Informe del proveedor tras la ejecución
El informe debe mostrar la carga realmente generada y el resultado de cada operación de negocio. Por separado se indican las limitaciones y los responsables de las correcciones. Un solo gráfico de latencia media no es suficiente.
El cliente necesita el perfil temporal, el estado de la impresión y el funcionamiento del respaldo. Para los defectos críticos se añade el resultado de una nueva ejecución según el escenario original.
En el informe se incluye:
- la versión del sistema y del escenario;
- la versión de los datos de prueba y del equipamiento;
- el perfil previsto de inicio de operaciones;
- el perfil realmente generado;
- los resultados de cada operación individual;
- errores y tiempos de espera agotados;
- las respuestas «Demasiadas solicitudes» y el comportamiento de las repeticiones;
dropped_iterationsy los recursos del generador;- el tiempo total de servicio en el puesto de trabajo;
- la cola de impresión y los casos de reemisión;
- el resultado del cambio al respaldo y de la recuperación;
- la lista de defectos, los responsables y los criterios de nueva verificación.
Vinculamos el defecto con un escenario reproducible. En la ficha se conservan las condiciones iniciales y la secuencia de acciones. Ahí mismo indicamos el resultado esperado y lo que el equipo vio en la ejecución.
Para continuar el trabajo se registran el impacto, la medida temporal y el responsable. El enfoque general puede contrastarse con el registro de incidentes en el evento. Antes de la apertura del recinto, los defectos se gestionan por separado del registro de trabajo del evento.
El mensaje «corregido» no cierra la observación. El equipo repite el mismo escenario con condiciones iniciales comparables. Si el resultado cambia, en el informe aparece un nuevo PASS. Si no, el defecto sigue abierto o se acepta como una limitación explícitamente acordada.
Lista de verificación de aceptación para el cliente
Necesita una lista breve de confirmaciones claras, no acceso a cada gráfico técnico. Antes de finalizar el ensayo, compruebe que el perfil de llegada se ha reproducido, que los casos complejos no han detenido el flujo principal y que el respaldo está activado de hecho. Asigne un responsable por cada defecto crítico y, tras la corrección, realice una nueva ejecución con el resultado registrado.
- Están descritas las ventanas de llegada, las entradas y la composición de las operaciones.
- La ejecución base de cada ruta se completa antes de la gran carga.
- El flujo esperado y el pico repentino se han realizado por separado.
- La intensidad real coincide con el plan o la discrepancia está explicada.
- Un QR correcto termina en una única marca válida.
- La repetición tras un tiempo de espera agotado no genera un duplicado.
- La impresión se ha verificado en impresoras y consumibles reales.
- Los casos manuales van a una línea separada y no bloquean el flujo principal.
- Los operadores ven estados claros y la siguiente acción.
- Se han utilizado datos sintéticos con accesos restringidos.
- El fallo de una dependencia y la recuperación se han probado en la práctica.
- Cada defecto crítico se ha vuelto a comprobar tras la corrección.
El ensayo presencial conviene estructurarlo con las mismas reglas que el ensayo técnico del evento: guion, resultado observable, responsable de la observación y nueva comprobación. La diferencia está en el enfoque: aquí todo el equipo se centra únicamente en el circuito de registro y sus dependencias.
La aceptación debe abarcar todo el recorrido del invitado bajo un flujo real, en caso de fallo y tras la recuperación. Un escáner o un formulario aislados no ofrecen una visión completa.
Preguntas frecuentes
El ensayo de carga del registro debe demostrar que todo el recorrido del invitado funciona con un flujo real: se encuentra el registro, se lee el código QR, el estado cambia una sola vez, se imprime la acreditación y el resultado es visible en los puestos de trabajo contiguos. Aquí el check-in es la búsqueda del registro y la fijación de la llegada del invitado. Una respuesta correcta de un formulario aislado o una señal sonora del escáner todavía no demuestran la preparación de todo el proceso.
Definimos el pico mediante el escenario de llegada de los invitados, no mediante un número redondo de usuarios virtuales. El cliente describe las franjas de llegada, la proporción del grupo principal, varias entradas, los casos manuales y las operaciones simultáneas. El equipo técnico calcula cuántas operaciones comienzan cada minuto y cuánto dura cada etapa.
El escenario debe reproducir las operaciones de negocio que realiza el equipo en la entrada, incluidas las excepciones. Comprobar una sola página de registro genera una falsa sensación de preparación. El flujo principal se ejecuta junto con la búsqueda manual, el QR repetido, el registro tardío y la impresión, para ver la competencia por los recursos compartidos y el impacto de los casos complejos en la cola.
En nuestro protocolo de aceptación utilizamos tres modos: una comprobación breve de la cadena básica, el flujo de trabajo esperado y un pico brusco. Responden a preguntas distintas. Una única rampa suave puede ocultar un error del escenario, y la búsqueda de la capacidad límite no confirma que el pico acordado cumpla los criterios de negocio.
Para el ensayo es mejor utilizar perfiles sintéticos que reproduzcan la estructura de la base de invitados sin contactos reales. El conjunto incluye distintos roles y categorías. Registros concretos imitan apellidos parecidos, cambios tardíos y excepciones. Antes del lanzamiento, el equipo acuerda los accesos y el plazo de eliminación, y traslada los envíos externos a un entorno de prueba seguro.
PASS/FAIL significa «superado / no superado» según un criterio registrado de antemano. Registre los criterios de aceptación antes de la prueba y vincúlelos al recorrido del invitado prometido. No existe una norma universal de latencia ni de número de operaciones. El equipo del proyecto define el flujo admisible, los errores, el tiempo de servicio y las reglas de parada, y después compara con ellos el resultado real sin ajustar los umbrales a posteriori.
Envíe su solicitud: hablemos de su proyecto
Concretaremos el formato del evento y le propondremos el siguiente paso.
Fuentes
- Grafana k6: tipos de pruebas de carga
- Grafana k6: criterios de thresholds
- Grafana k6: dropped iterations
- Microsoft Azure Architecture Center: antipatrón Retry Storm
- Microsoft Azure Architecture Center: patrón Retry
- Zebra DataWedge: entrada y retroalimentación de códigos de barras
- GS1: guía de calidad y legibilidad de códigos bidimensionales
- IETF RFC 6585: HTTP 429 Too Many Requests
- W3C WCAG 2.2: Status Messages
- Ley Federal n.º 152-FZ: principios del tratamiento de datos personales
Índice
¿Te resultó útil el artículo?