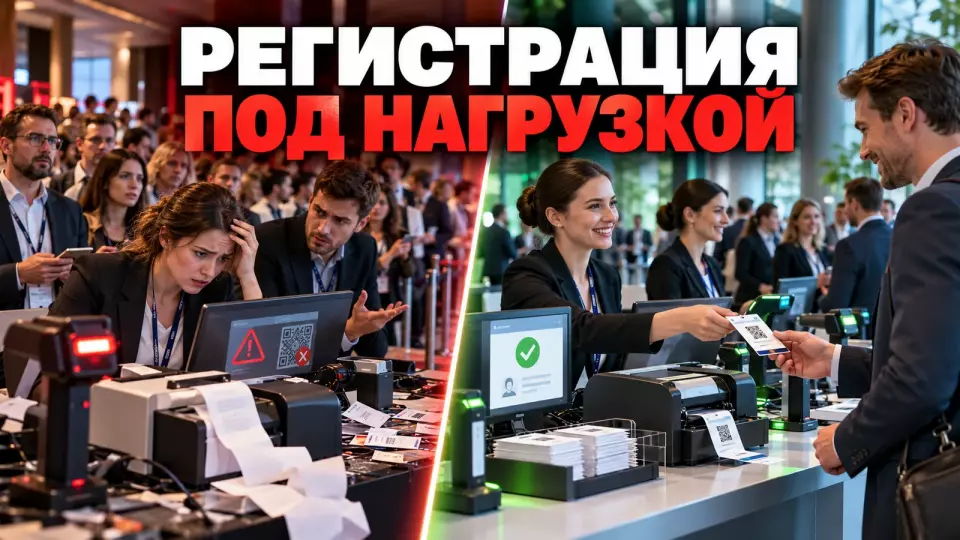
Un plan pratique pour la recette de l'inscription sous charge : scénarios de pic, données sécurisées, redondance, critères PASS/FAIL et rapport du prestataire.
Laissez une demande - nous discuterons de votre projet
Nous préciserons le format de l'événement et proposerons la prochaine étape.
Que doit démontrer une répétition en charge ?
Une répétition en charge de l'enregistrement doit prouver que tout le parcours du participant fonctionne avec un flux réel : l'inscription est retrouvée, le QR code est lu, le statut change une seule fois, le badge est imprimé et le résultat est visible sur les postes de travail voisins. Ici, le check-in consiste à rechercher l'inscription et à enregistrer l'arrivée du participant. Une réponse réussie d'un formulaire isolé ou un signal sonore du scanner ne prouvent pas encore que l'ensemble du processus est prêt.
Chez Aventura, nous définissons d'abord le périmètre de la vérification. Le participant présente son invitation ou demande que l'on retrouve son inscription. Le système vérifie le statut, enregistre l'arrivée et transmet les données à l'impression.
L'opérateur reçoit une confirmation claire. La cartographie des dépendances inclut également les services externes.
Le parcours global d'enregistrement est détaillé dans l'article consacré à l'enregistrement des participants à un événement. Ici, l'objectif est plus restreint : vérifier ce parcours sous charge et obtenir une décision « réussi » ou « non réussi » selon des critères définis à l'avance.
Le scanner peut émettre un son après le décodage réussi du code-barres. Cela confirme la lecture du symbole par l'appareil, mais pas l'enregistrement d'un nouveau statut dans le système central. C'est pourquoi l'observateur vérifie l'écran de l'opérateur, la fiche du participant, l'impression et l'export final, et pas seulement la réaction du scanner.
Le pic de flux selon le client
Nous définissons le pic à partir du scénario d'arrivée des participants, et non à partir d'un nombre rond d'utilisateurs virtuels. Le client décrit les fenêtres d'arrivée, la part du groupe principal, plusieurs entrées, les cas manuels et les opérations simultanées. L'équipe technique calcule combien d'opérations démarrent chaque minute et combien de temps dure chaque étape.
Pour l'organisation d'une conférence, il est utile de rassembler le planning des transports, le début de la séance plénière, l'accès aux sessions et les règles de remise des documents. Un bus ou la fin d'un bloc commun crée un pic de demande. Les participants continuent d'arriver même lorsque les opérations précédentes ont déjà ralenti.
Le modèle minimal comprend :
- le nombre de participants attendus par fenêtre horaire ;
- la part des QR codes, de la recherche manuelle et des participants sans inscription préalable ;
- le nombre d'entrées, de comptoirs, de scanners et d'imprimantes ;
- la part des scans répétés et des réimpressions ;
- les modifications tardives de statut ou de catégorie ;
- les dépendances vis-à-vis du réseau, de la messagerie, des SMS et des bases externes.
Un tel profil permet de mettre en regard la charge technique et la file d'attente visible. Le serveur peut répondre rapidement alors que le poste de travail traite néanmoins le participant lentement en raison de la recherche, de l'impression ou d'une erreur peu claire. C'est pourquoi on mesure séparément l'opération système et le cycle complet au comptoir.
Quelles opérations inclure dans le scénario ?
Le scénario doit reproduire les opérations métier que l'équipe effectue à l'entrée, y compris les exceptions. Tester une seule page d'inscription donne une fausse impression de maîtrise. Le flux principal se lance avec la recherche manuelle, le QR répété, l'enregistrement tardif et l'impression, afin de voir la concurrence pour les ressources partagées et l'impact des cas complexes sur la file d'attente.
Nous construisons le parcours ainsi :
- L'invité présente un QR code ou donne ses données pour la recherche.
- L'opérateur trouve la bonne fiche.
- Le système vérifie le statut actuel et les droits d'accès.
- Le check-in modifie le statut exactement une fois.
- L'imprimante délivre un badge avec la catégorie à jour.
- Le comptoir voisin voit la modification sans actualisation manuelle des données.
- L'export final contient une seule marque confirmée.
On ajoute au scénario une faute de frappe, un homonyme, un cas sans QR code, un code déjà utilisé, une inscription tardive et une demande de badge en double. L'ensemble détaillé des supports peut être vérifié dans l'article sur les QR codes sécurisés lors d'un événement, sans transformer le test de charge en audit distinct de la sécurité des QR codes.
Une modification tardive doit elle aussi parcourir tout le circuit. La fiche est créée ou modifiée après l'export de contrôle, puis on vérifie la recherche, les droits, l'impression et la diffusion du nouveau statut. Le contenu voisin sur les inscriptions tardives aide à préparer un tel scénario sans reprendre tout le calendrier du projet.
L'inscription est intégrée à la production de l'événement dans son ensemble. Si vous avez besoin du circuit global du site, des prestataires et de l'équipe d'accueil, consultez l'organisation d'événements d'entreprise : nous convenons à l'avance des rôles, des points de contrôle et des solutions de repli.
Nous publions également des analyses pratiques sur la préparation du site et le travail de l'équipe dans la chaîne Telegram d'Aventura.
Trois modes de test
Dans notre protocole de recette, nous utilisons trois modes : une vérification courte de la chaîne de base, le flux de travail attendu et un pic brutal. Ils répondent à des questions différentes. Une montée en charge progressive peut masquer une erreur de scénario, et la recherche de la puissance maximale ne confirme pas que le pic convenu respecte les critères métier.
Le tableau rassemble les points clés de la section : Mode, Ce que nous lançons, Ce que nous voulons savoir. Utilisez-le comme repère rapide lors de la préparation de l'événement.
| Mode | Ce que nous lançons | Ce que nous voulons savoir | Décision du client |
|---|---|---|---|
| Test de base | quelques enregistrements de chaque type | la chaîne fonctionne-t-elle et les données de test sont-elles correctes | peut-on passer à une charge importante |
| Flux attendu | profil d'arrivée projeté dans le temps | le système supporte-t-il le scénario de travail convenu | le critère principal de recette est-il validé |
| Pic brutal | croissance rapide du démarrage des opérations | comment se manifeste la dégradation et l'équipe la voit-elle | la réserve est-elle suffisante et les conditions d'arrêt sont-elles claires |
La documentation de k6 propose des modes distincts pour la vérification de base, la charge normale, la surcharge, le pic brutal et la recherche de la limite du système. Le client n'a pas besoin de maîtriser la configuration de l'outil, mais il doit comprendre l'objectif du test.
Un mode montre la réaction à une affluence soudaine, un autre cherche la limite. Le test de production confirme un scénario d'événement concret.
Avant la grande répétition, l'équipe effectue un test de base de chaque parcours. Il détecte les enregistrements de test erronés, le manque d'autorisations nécessaires et les erreurs d'intégration. Ensuite, la charge augmente selon le profil convenu, et non selon l'improvisation d'un technicien.
Comment préparer des données de test sécurisées ?
Pour la répétition, il est préférable d'utiliser des profils synthétiques qui reproduisent la structure de la base des invités sans contacts réels. Le jeu comprend différents rôles et catégories. Certaines entrées imitent des noms de famille similaires, des modifications tardives et des exceptions. Avant le lancement, l'équipe valide les accès et le délai de suppression, et bascule les envois externes vers un circuit de test sécurisé.
Les principes de l'article 5 de la loi fédérale n° 152-FZ exigent une finalité précise du traitement, la conformité des données à cette finalité et l'absence d'excès. Pour un test de charge, c'est un argument pratique pour ne pas copier la base de production « pour le réalisme » si le même scénario peut être reproduit avec des enregistrements fictifs.
Le jeu est préparé étape par étape :
- On détermine les champs et statuts qui participent réellement au check-in.
- On crée des enregistrements synthétiques des catégories et de la répartition nécessaires.
- On marque séparément les enregistrements pour un QR répété, une modification tardive et une réimpression.
- On limite les accès des opérateurs et des observateurs à des rôles de test.
- On bloque l'envoi d'e-mails et de messages à de vrais destinataires.
- On fixe le délai de suppression des enregistrements, des logs et des exports après la recette.
Les exigences juridiques relatives au formulaire et aux consentements doivent être vérifiées séparément. Pour cela, il existe un document sur le formulaire d'inscription selon la loi n° 152-FZ. Lors de la répétition de charge, nous vérifions le schéma de données déjà validé. La composition des enregistrements de test, les accès, la journalisation et les durées de conservation sont convenus avec le responsable des données personnelles ou un juriste.
Critères « réussi / non réussi » (PASS/FAIL) avant le lancement
PASS/FAIL signifie « réussi / non réussi » selon un critère consigné à l'avance. Consignez les critères d'acceptation avant le test et reliez-les au parcours client promis. Il n'existe pas de norme universelle de latence ni de nombre d'opérations. L'équipe projet définit le débit admissible, les erreurs, le temps de service et les règles d'arrêt, puis compare le résultat réel à ces valeurs sans ajuster les seuils a posteriori.
Le tableau rassemble les points clés de la section : Objet, Ce qu'il faut consigner, Exemple de formulation du critère sans normatif inventé. Utilisez-le comme repère rapide lors de la préparation de l'événement.
| Objet | Ce qu'il faut consigner | Exemple de formulation du critère sans normatif inventé |
|---|---|---|
| Débit | opérations commencées dans le temps | un profil convenu est créé sans chutes inexpliquées du générateur |
| Check-in | temps, erreurs, délais d'attente dépassés, réponse « trop de requêtes » | l'opération respecte le seuil projet pour la part convenue des requêtes |
| Statut métier | enregistrement final et doublon | une opération crée une seule marque correcte |
| Impression | file d'attente et conformité du badge | le badge correspond à l'enregistrement en cours et n'est pas réimprimé sans raison |
| Poste de travail | cycle complet de service | l'opérateur termine le scénario sans contourner le processus validé |
| Secours | bascule et contre-vérification | les données après restauration se recoupent sans pertes ni doubles entrées |
Les conditions de seuil k6 indiquent automatiquement si le critère est réussi pour la métrique. Les valeurs concrètes issues de la documentation ne doivent pas être reprises dans le projet comme normatif. Elles sont définies par le propriétaire du système, le client et l'équipe opérationnelle en tenant compte de la file d'attente admissible et du service promis.
Un critère particulier concerne le générateur de charge. Si les opérations prévues n'ont pas été lancées, le rapport décrit un débit inférieur à celui annoncé. La métrique dropped_iterations aide à distinguer la dégradation du système testé d'un manque de ressources ou d'une mauvaise configuration du générateur lui-même.
Que casser pendant la répétition ?
Pendant la répétition, nous désactivons ou ralentissons tour à tour certaines dépendances dans une fenêtre convenue : réseau, imprimante, service externe ou un poste de travail. L'équipe vérifie la vitesse de détection, la clarté du message et le passage au secours. Chaque panne est déclenchée selon un scénario, avec droit d'arrêt immédiat et un responsable de l'exercice désigné à l'avance.
Un ensemble utile de défaillances :
- réseau lent ou brièvement indisponible ;
- panne d'un scanner ou d'une imprimante ;
- réponse perdue après un check-in réellement effectué ;
- réponse HTTP « Trop de requêtes » avec indication du délai avant nouvel essai ;
- base externe ou service d'impression indisponible ;
- nouvelle pression de l'opérateur en raison d'un statut peu clair ;
- rétablissement de la dépendance après des marquages manuels.
Des répétitions automatiques immédiates peuvent créer une nouvelle vague de requêtes : un service déjà surchargé reçoit encore plus d'appels et met plus longtemps à se rétablir. Si l'opération modifie le statut d'un invité, une répétition aveugle peut créer un doublon. Le système doit distinguer la répétition sûre, l'attente et la vérification manuelle du résultat.
Il vaut mieux coordonner la partie réseau avec le responsable de l'infrastructure du site. L'article sur le Wi-Fi invité en conférence explique pourquoi l'enregistrement de service ne doit pas être évalué par un test de vitesse global commun avec le trafic invité.
Stands, QR codes et retours
Le test en laboratoire est complété par un essai en conditions réelles sur les stands, appareils et supports réels. L'équipe vérifie les écrans de téléphones à différentes luminosités, les codes papier, les reflets, la présentation répétée et le bruit. L'opérateur doit voir un résultat d'opération sans ambiguïté, qui ne dépende pas uniquement du son ou de la couleur dans l'interface.
GS1 associe la lisibilité d'un code bidimensionnel à la zone libre autour du symbole, au contraste, à une grille régulière et à l'absence de bruit graphique. C'est pourquoi l'essai inclut les tailles, matériaux et modes de présentation que recevront les invités. Une image de test parfaite sur un écran ne remplace pas un support réel.
Dans notre scénario, nous vérifions six états distincts : « code lu », « vérification en cours », « entrée confirmée », « déjà marqué », « enregistrement introuvable » et « pas de connexion ». Les recommandations du W3C sur les messages de statut exigent que le changement d'état puisse être déterminé par programme sans déplacement forcé du focus. Pour un stand, c'est aussi une question de rapidité de formation du personnel.
Le schéma physique des entrées, les files d'attente et le placement des équipements doivent être pris en compte lors du choix du site. Le système peut réussir le test côté serveur mais perdre en débit à cause d'un hall étroit, d'une file commune à plusieurs catégories ou d'une imprimante à laquelle les opérateurs accèdent en traversant le flux des invités.
Comment vérifier la redondance et la restauration ?
Une solution de secours n'est considérée comme opérationnelle qu'après une bascule effective, la poursuite des entrées et une réconciliation inverse. Si un mode local ou autonome est annoncé, l'équipe déconnecte la dépendance principale, accumule les opérations, rétablit la connexion et vérifie les conflits. En l'absence de mode autonome, on répète le processus manuel et la commande de bascule unique pour tous les postes.
Le scénario de restauration se déroule ainsi :
- Le responsable de l'exercice annonce la défaillance de la dépendance choisie.
- L'équipe consigne l'heure de détection et le symptôme visible.
- Le responsable de l'enregistrement donne une commande de bascule unique et concertée.
- Les opérateurs poursuivent les entrées via l'itinéraire de secours.
- L'observateur consigne les marques manuelles et locales.
- Le service principal est rétabli selon un ordre convenu.
- Les données sont réconciliées, les conflits traités, la version finale confirmée.
Le schéma détaillé de connexion et de gestion des listes locales figure dans l'article sur un événement sans internet mobile. Dans cet exercice, les points de bascule et la resynchronisation sont essentiels : qui donne la commande, ce que voit l'opérateur et comment est exclue la double marque de présence.
La solution de secours ne doit pas être activée de sa propre initiative par chaque poste. Des décisions locales non concertées créent plusieurs versions de la vérité. Un seul responsable décide du mode, et le journal de l'exercice conserve l'heure, la cause et la portée.
Rapport du prestataire après le test
Le rapport doit présenter la charge réellement générée et le résultat de chaque opération métier. Les limites et les responsables des corrections sont indiqués séparément. Un simple graphique de latence moyenne ne suffit pas.
Le client a besoin du profil temporel, de l'état de l'impression et du fonctionnement du secours. Pour les défauts critiques, on ajoute le résultat d'un nouveau test selon le scénario initial.
Le rapport comprend :
- la version du système et du scénario ;
- la version des données de test et du matériel ;
- le profil prévu du début des opérations ;
- le profil réellement généré ;
- les résultats de chaque opération individuelle ;
- les erreurs et les délais d'attente ;
- les réponses « Trop de requêtes » et le comportement des répétitions ;
dropped_iterationset les ressources du générateur ;- le temps de service complet sur le poste de travail ;
- la file d'impression et les cas de réémission ;
- le résultat du basculement sur le secours et de la restauration ;
- la liste des défauts, les responsables et les critères de nouvelle vérification.
Nous associons le défaut à un scénario reproductible. La fiche conserve les conditions initiales et l'ordre des actions. On y indique également le résultat attendu et ce que l'équipe a observé lors du test.
Pour poursuivre le travail, on consigne l'impact, la mesure temporaire et le responsable. L'approche générale peut être vérifiée avec le journal des incidents lors de l'événement. Avant l'ouverture du site, les défauts sont traités séparément du journal de travail de l'événement.
Le message « corrigé » ne clôt pas la remarque. L'équipe répète le même scénario avec des conditions initiales comparables. Si le résultat a changé, un nouveau PASS apparaît dans le rapport. Sinon, le défaut reste ouvert ou est accepté comme une limite explicitement convenue.
Check-list de réception pour le client
Vous avez besoin d'une courte liste de confirmations compréhensibles, et non d'un accès à chaque planning technique. Avant la fin de la répétition, vérifiez que le profil d'arrivée est reproduit, que les cas complexes n'ont pas bloqué le flux principal et que le secours est réellement activé. Pour chaque défaut critique, désignez un responsable et, après correction, effectuez un nouveau passage avec un résultat consigné.
- Les fenêtres d'arrivée, les entrées et la composition des opérations sont décrites.
- Le passage de base de chaque parcours est terminé avant la forte charge.
- Le flux attendu et le pic soudain ont été testés séparément.
- L'intensité réelle correspond au plan ou l'écart est expliqué.
- Un QR réussi se termine par une seule validation correcte.
- Une nouvelle tentative après un délai d'attente ne crée pas de doublon.
- L'impression a été vérifiée sur des imprimantes et consommables réels.
- Les cas manuels passent par une file distincte et ne bloquent pas le flux principal.
- Les opérateurs voient des statuts clairs et l'action suivante.
- Des données synthétiques avec des accès restreints ont été utilisées.
- La défaillance d'une dépendance et la restauration ont été testées en pratique.
- Chaque défaut critique a été revérifié après correction.
Il est pratique de construire la répétition en présentiel selon les mêmes règles que la répétition technique de l'événement : scénario, résultat observable, responsable du constat et nouvelle vérification. La différence porte sur le point d'attention : ici, toute l'équipe se concentre uniquement sur le circuit d'enregistrement et ses dépendances.
La réception doit couvrir tout le parcours du guest sous un flux réel, en cas d'incident et après restauration. Un scanner ou un formulaire isolé ne donnent pas une vision complète.
Questions fréquentes
La répétition en charge de l'enregistrement doit montrer que tout le parcours du participant fonctionne avec un flux réel : l'inscription est retrouvée, le QR code est scanné, le statut change une seule fois, le badge est imprimé et le résultat est visible sur les postes de travail voisins. Ici, le check-in consiste à rechercher l'inscription et à enregistrer l'arrivée du participant. La réponse réussie d'un formulaire isolé ou le signal sonore du scanner ne prouvent pas encore que l'ensemble du processus est prêt.
Nous définissons le pic à partir du scénario d'arrivée des participants, et non à partir d'un nombre rond d'utilisateurs virtuels. Le client décrit les fenêtres d'arrivée, la part du groupe principal, les différents points d'entrée, les cas manuels et les opérations simultanées. L'équipe technique calcule combien d'opérations démarrent chaque minute et combien de temps dure chaque étape.
Le scénario doit reproduire les opérations métier réalisées par l'équipe à l'entrée, y compris les exceptions. Tester une seule page d'enregistrement donne une fausse impression de préparation. Le flux principal est lancé avec la recherche manuelle, le QR code répété, l'inscription tardive et l'impression, afin de voir la concurrence pour les ressources partagées et l'impact des cas complexes sur la file d'attente.
Dans notre protocole de recette, nous utilisons trois modes : une vérification courte de la chaîne de base, le flux de travail attendu et un pic brutal. Ils répondent à des questions différentes. Une montée en charge progressive peut masquer une erreur de scénario, et la recherche de la capacité maximale ne confirme pas que le pic convenu respecte les critères métier.
Pour la répétition, il est préférable d'utiliser des profils synthétiques qui reproduisent la structure de la base des participants sans contacts réels. Le jeu de données comprend différents rôles et catégories. Certaines inscriptions imitent des noms de famille similaires, des modifications tardives et des exceptions. Avant le lancement, l'équipe valide les accès et la durée de suppression, et bascule les envois externes vers un environnement de test sécurisé.
PASS/FAIL signifie « réussi / échoué » selon un critère défini à l'avance. Consignez les critères de recette avant le test et reliez-les au parcours participant promis. Il n'existe pas de norme universelle de latence ou de nombre d'opérations. L'équipe projet définit le flux admissible, les erreurs, le temps de service et les règles d'arrêt, puis compare le résultat réel à ces critères sans ajuster les seuils a posteriori.
Laissez une demande : nous discuterons de votre projet
Nous préciserons le format de l'événement et proposerons la prochaine étape.
Sources
- Grafana k6 : types de tests de charge
- Grafana k6 : critères de seuils (thresholds)
- Grafana k6 : itérations abandonnées (dropped iterations)
- Microsoft Azure Architecture Center : antipattern Retry Storm
- Microsoft Azure Architecture Center : modèle Retry
- Zebra DataWedge : saisie et retour d'information des codes-barres
- GS1 : guide sur la qualité et la lisibilité des codes bidimensionnels
- IETF RFC 6585 : HTTP 429 Too Many Requests
- W3C WCAG 2.2 : messages d'état (Status Messages)
- Loi fédérale n° 152-FZ : principes du traitement des données personnelles
Sources
Sommaire